

Eine Maschine soll eine weitere Produktvariante fertigen, eine neue Funktion erhalten oder um einen digitalen Service ergänzt werden. Der Aufwand dafür hängt längst nicht mehr allein von Mechanik und Elektrik ab. Immer häufiger entscheidet die Softwarearchitektur darüber, ob sich eine Anforderung gezielt umsetzen lässt oder ob dafür weite Teile des Systems geändert werden müssen.
Software Defined Manufacturing, kurz SDM, setzt hier an. Maschinenfähigkeiten werden in klar abgegrenzten Softwarebausteinen mit definierten Schnittstellen umgesetzt. Dadurch lassen sie sich unabhängiger von einzelnen Hardwarekonfigurationen weiterentwickeln und für unterschiedliche Maschinenvarianten nutzen. Für Maschinenhersteller entsteht so die Grundlage, mit einmal entwickelten Funktionen über den gesamten Produktlebenszyklus hinweg mehr Wert zu schaffen.
Künstliche Intelligenz (KI) kann diese Entwicklung beschleunigen, indem sie Code analysiert, Implementierungen vorschlägt und Tests ableitet. Schneller erzeugter Code beantwortet jedoch noch nicht die entscheidende Frage:
Wie bleiben Änderungen über viele Varianten und einen langen Produktlebenszyklus hinweg kontrollierbar?
Vom Maschinenprojekt zum Softwareprodukt
In vielen Unternehmen ist die Maschinensoftware über einzelne Kundenprojekte hinweg gewachsen. Funktionen wurden für eine Anlage umgesetzt, später kopiert und für die nächste Variante angepasst. So entstehen ähnliche Softwarestände mit unterschiedlichen Abhängigkeiten. Das Wissen über frühere Entscheidungen liegt häufig verstreut in Tickets und Projektordnern oder nur bei einzelnen Fachleuten.
Dieses Vorgehen wird zum Hindernis, sobald sich Maschinenhersteller zunehmend durch Softwarefunktionen vom Wettbewerb abheben wollen. Wer solche Funktionen über Jahre weiterentwickeln, auf weitere Maschinenvarianten übertragen oder als digitale Services anbieten will, kann sie nicht dauerhaft als projektspezifische Sonderlösungen behandeln.
SDM erweitert deshalb den Blick vom einzelnen Maschinenprojekt auf ein kontinuierlich weiterentwickelbares Softwareprodukt. Für Fähigkeiten wie Positionieren, Prüfen oder Diagnostizieren werden Softwarebausteine mit klaren Zuständigkeiten und definierten Schnittstellen geschaffen. Ihre interne Umsetzung kann sich verändern, solange die vereinbarten Anforderungen weiterhin erfüllt werden. Ob eine solche Änderung auf den jeweiligen Baustein begrenzt bleibt oder weitere Teile der Maschine betrifft, hängt maßgeblich von der Softwarearchitektur ab.
Ein kleiner Änderungsradius macht Wandelbarkeit beherrschbar
Eine softwaredefinierte Maschine braucht eine Architektur, die Zuständigkeiten sichtbar macht und Abhängigkeiten begrenzt. Zeitkritische Aufgaben wie die Regelung und Ansteuerung von Antrieben, Safety-Funktionen oder synchronisierte Maschinenabläufe verbleiben in den dafür ausgelegten Steuerungen und hardwarenahen Systemen. Diese müssen die jeweils erforderlichen Zeit- und Sicherheitsanforderungen erfüllen. Funktionen zur Analyse, Dokumentation oder Optimierung können in getrennten Komponenten ausgeführt werden. Definierte Schnittstellen regeln den Austausch zwischen diesen Bereichen. OPC UA kann dafür die technische und semantische Verbindung schaffen, während Verwaltungsschalen Eigenschaften, Zustände und Fähigkeiten einheitlich beschreiben.
Wie wichtig diese Aufteilung ist, zeigt ein vereinfachtes Szenario:
Eine optische Prüffunktion soll eine neue Produktvariante erkennen und bewerten. Fachlich betrifft die Erweiterung nur das Prüfmodul. Über seine Schnittstelle liefert es weiterhin das vereinbarte Prüfergebnis an den Maschinenablauf. Erfordert die Erweiterung jedoch auch Änderungen an einer gemeinsam genutzten Bibliothek für die Bildvorverarbeitung, können davon bestehende Varianten betroffen sein. Damit vergrößert sich der Änderungsradius und zusätzlicher Prüfaufwand entsteht.
Bevor Code entsteht, muss das Team deshalb klären, welche Module, Schnittstellen und gemeinsam genutzten Komponenten von der Änderung betroffen sind. Ebenso wichtig ist die Einordnung in die Laufzeitarchitektur: Muss das Prüfergebnis innerhalb einer garantierten Zeit im Maschinenzyklus vorliegen oder kann die Auswertung außerhalb des zeitkritischen Ablaufs erfolgen? Daraus ergeben sich Anforderungen an den Ausführungsort der Funktion und an das Verhalten des Systems bei Verzögerungen oder Ausfällen.
Erweiterbarkeit zeigt sich daran, dass sich neue Anforderungen umsetzen lassen, ohne bestehendes Verhalten unbeabsichtigt zu verändern. Klare Zuständigkeiten und stabile Schnittstellen schaffen dafür die Grundlage. Automatisierte Tests helfen zu überprüfen, ob neue Anforderungen erfüllt werden und bestehende Funktionen weiterhin wie vorgesehen arbeiten.
KI verschiebt den Engpass
SDM verlagert Veränderung von der Hardware in die Software
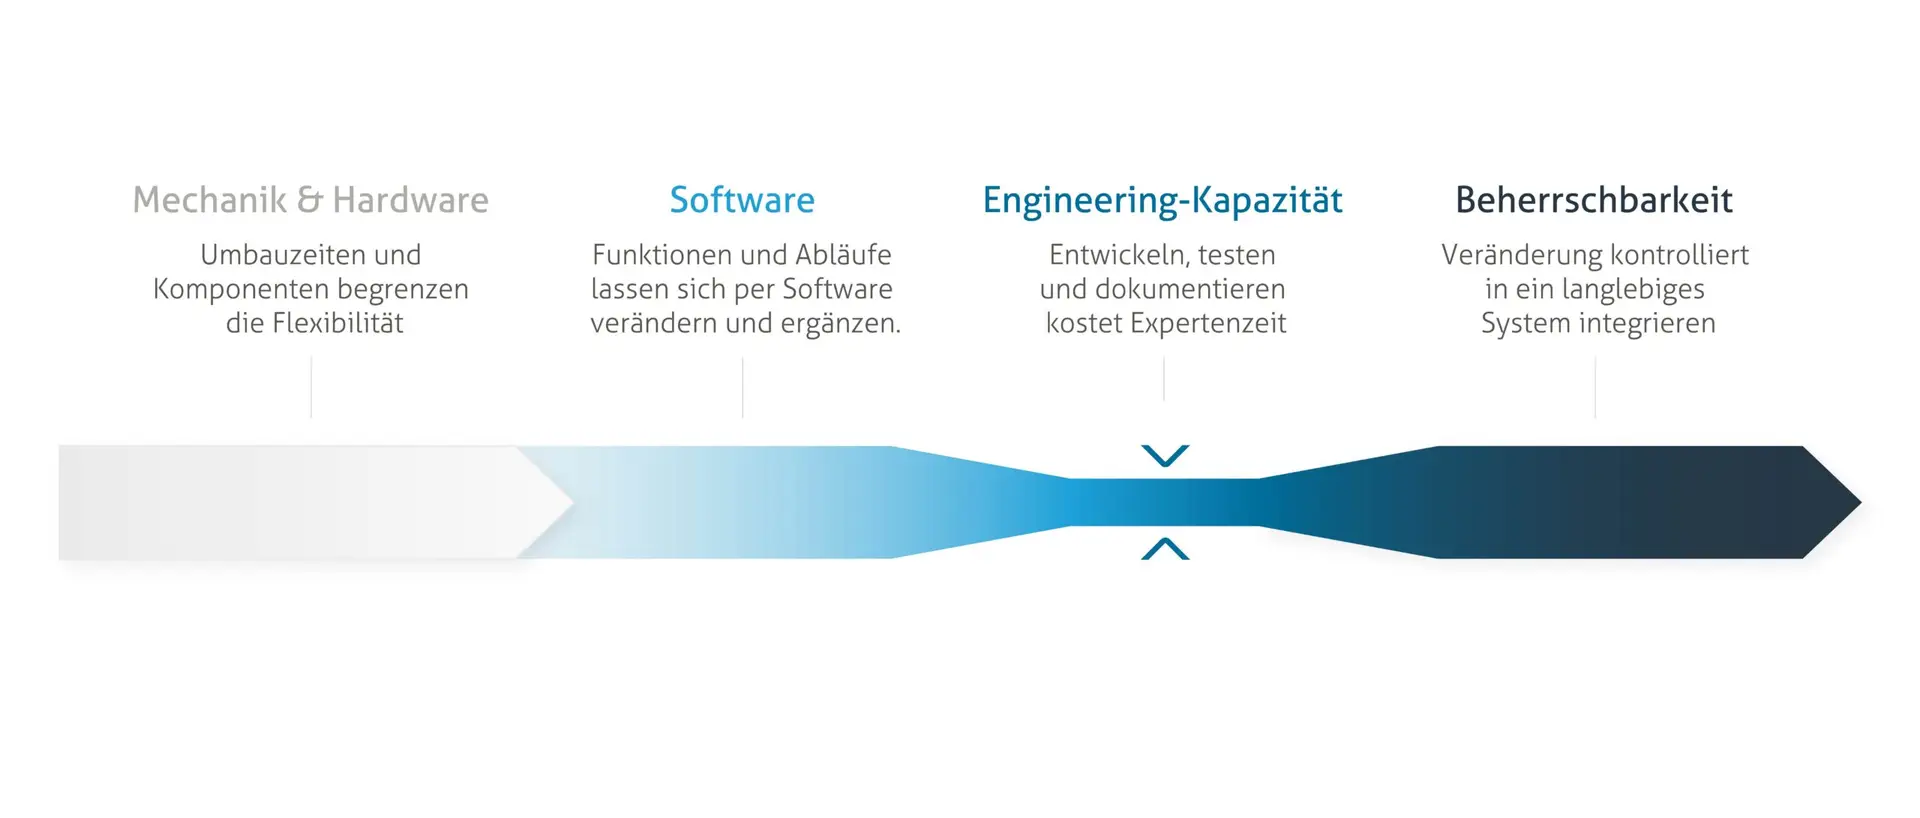
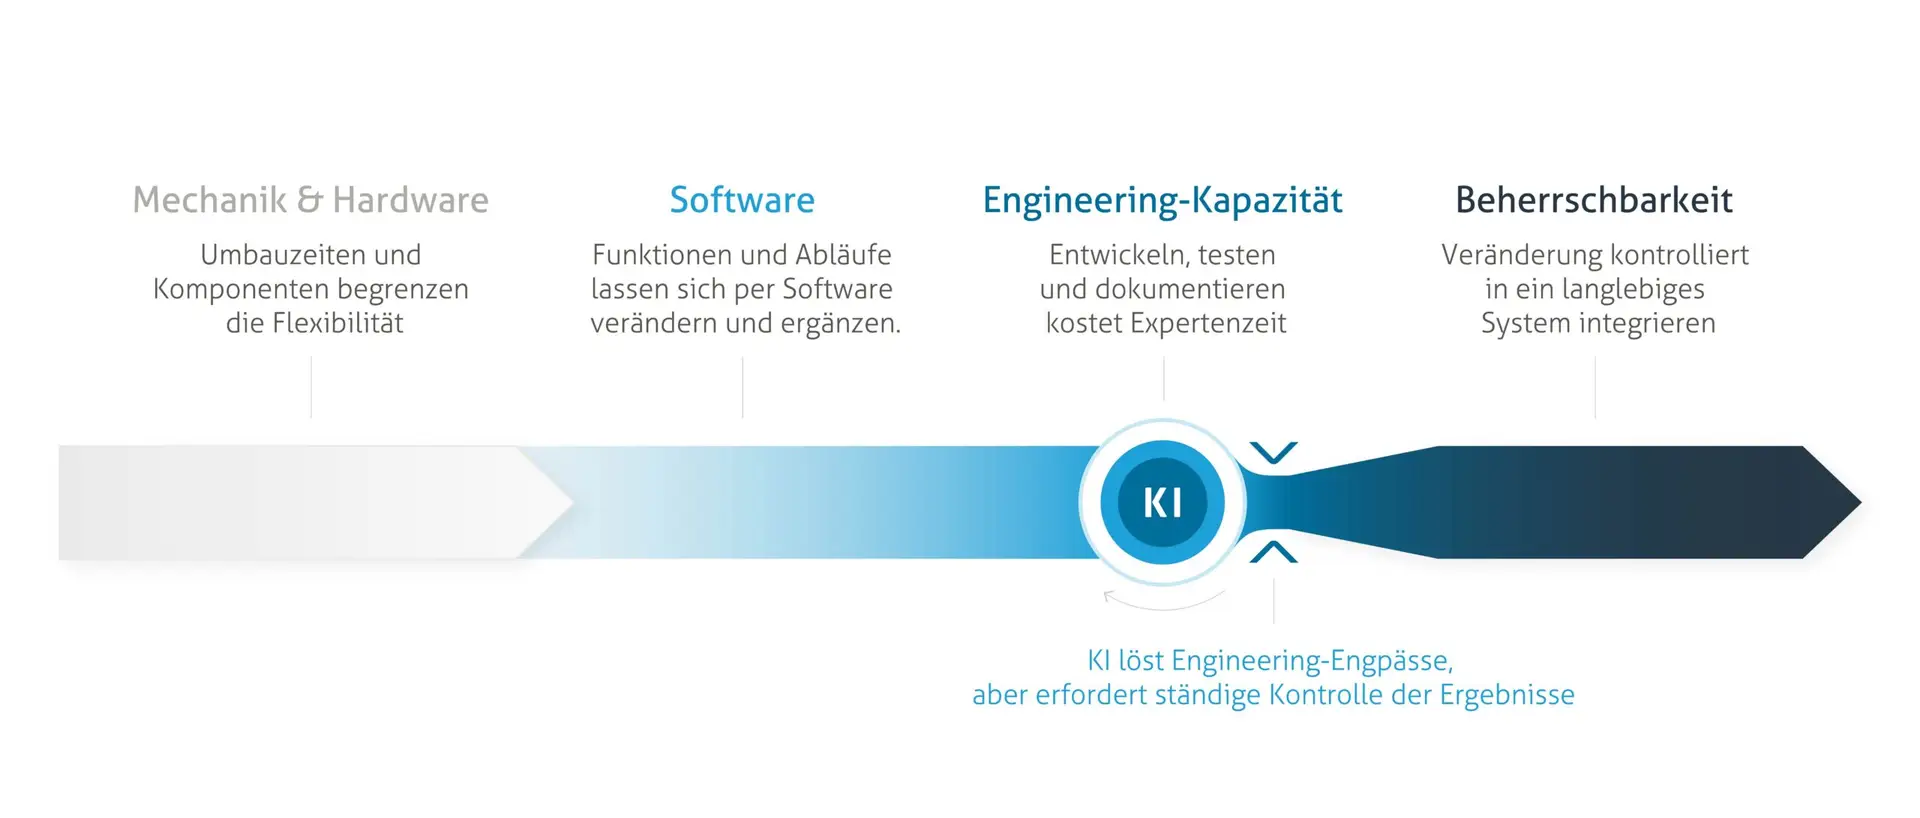
Je mehr Flexibilität aus Software entsteht, desto stärker bestimmen Engineering-Kapazitäten die Veränderungsgeschwindigkeit einer Maschine. Entwicklungsteams müssen Varianten pflegen, Auswirkungen beurteilen und Wissen über einen langen Produktlebenszyklus erhalten. Bei einer gewachsenen Codebasis kostet bereits das Verständnis einer Änderung viel Zeit.
Technische Schulden verschärfen diesen Engpass, weil unklare Modulgrenzen den Änderungsradius vergrößern und nicht dokumentierte Abhängigkeiten jede Anpassung riskanter machen. Ohne eine verlässliche Beschreibung des gewünschten Verhaltens muss das Team bei jeder Erweiterung erneut rekonstruieren, was die Software leisten soll.
Hier setzen KI-Werkzeuge an: Code wird erzeugt, analysiert und das Schreiben von Dokumentation wird beschleunigt. Damit verschiebt sich der Engpass: Wenn mehr Änderungen in kürzerer Zeit entstehen, müssen Unternehmen deren fachliche Richtigkeit und Auswirkungen ebenso schnell beurteilen können. Beherrschbarkeit und Kontrollierbarkeit werden damit zu Qualitätsmerkmalen der Software und letztlich der Maschine.
Warum ein Prompt als Grundlage nicht ausreicht
Ein Prompt enthält meist nur einen Ausschnitt des benötigten Wissens. Die KI kennt weder automatisch das Domänenvokabular des Unternehmens noch die Historie einer Funktion. Auch Modulgrenzen, Schnittstellen und frühere Architekturentscheidungen bleiben unsichtbar, wenn sie nicht strukturiert vorliegen.
Ein KI-Agent kann unter diesen Bedingungen plausiblen Code erzeugen, der im konkreten System dennoch auf falschen Annahmen beruht. Denn Anforderungen in natürlicher Sprache lassen häufig Interpretationsspielraum. Fehlt im Prompt der notwendige fachliche und technische Kontext, schließt der Agent diese Lücken mit Annahmen, die schlüssig wirken, aber nicht dem gewünschten Systemverhalten entsprechen.
Gelangt eine solche Annahme unbemerkt ins Repository, kann sie von späteren Änderungen übernommen und weitergetragen werden. Nach mehreren Entwicklungszyklen erscheint sie schließlich als gültiges Systemverhalten. Langfristig können daraus Fehlfunktionen, technische Schulden und ein wachsender Prüfaufwand entstehen.
Hien Nguyen, Softwareentwickler und KI-Experte bei iTE SI, fasst dieses Risiko so zusammen:

Der notwendige Kontext gehört deshalb in versionierte und überprüfbare Artefakte. Eine zentrale Rolle übernimmt die Featurebeschreibung. Sie beschreibt fachlich konkret, wie sich die Funktion verhalten soll, ohne eine bestimmte Implementierung vorzugeben. Ein gemeinsames Domänenvokabular hilft Menschen und KI, Begriffe einheitlich zu verwenden und zu verstehen. Ergänzend werden die betroffenen Module und Schnittstellen, stets einzuhaltende Bedingungen (Invarianten), Akzeptanzkriterien sowie das erwartete Verhalten bei Fehlern und Abbrüchen festgehalten.
Für die Prüffunktion beschreibt das Team beispielsweise, welche Produktvariante erkannt werden soll, welche Eingabedaten zulässig sind und welches Ergebnis die Funktion liefern soll. Ebenso wird festgelegt, was bei unvollständigen Bilddaten oder einer Zeitüberschreitung geschieht. Die freigegebene Beschreibung wird gemeinsam mit Code und Tests im Repository versioniert. So lässt sich später nachvollziehen, welche Anforderung einer Änderung zugrunde lag.
Ein prüfbarer KI-gestützter Entwicklungsprozess
KI kann verschiedene Schritte der Softwareentwicklung unterstützen. Entscheidend ist, dass für jede KI-gestützte Änderung klare Zuständigkeiten, überprüfbare Zwischenstände und definierte Freigaben gelten. Die folgenden fünf Schritte zeigen, wie sich dieses Prinzip in einem nachvollziehbaren Entwicklungsprozess umsetzen lässt.
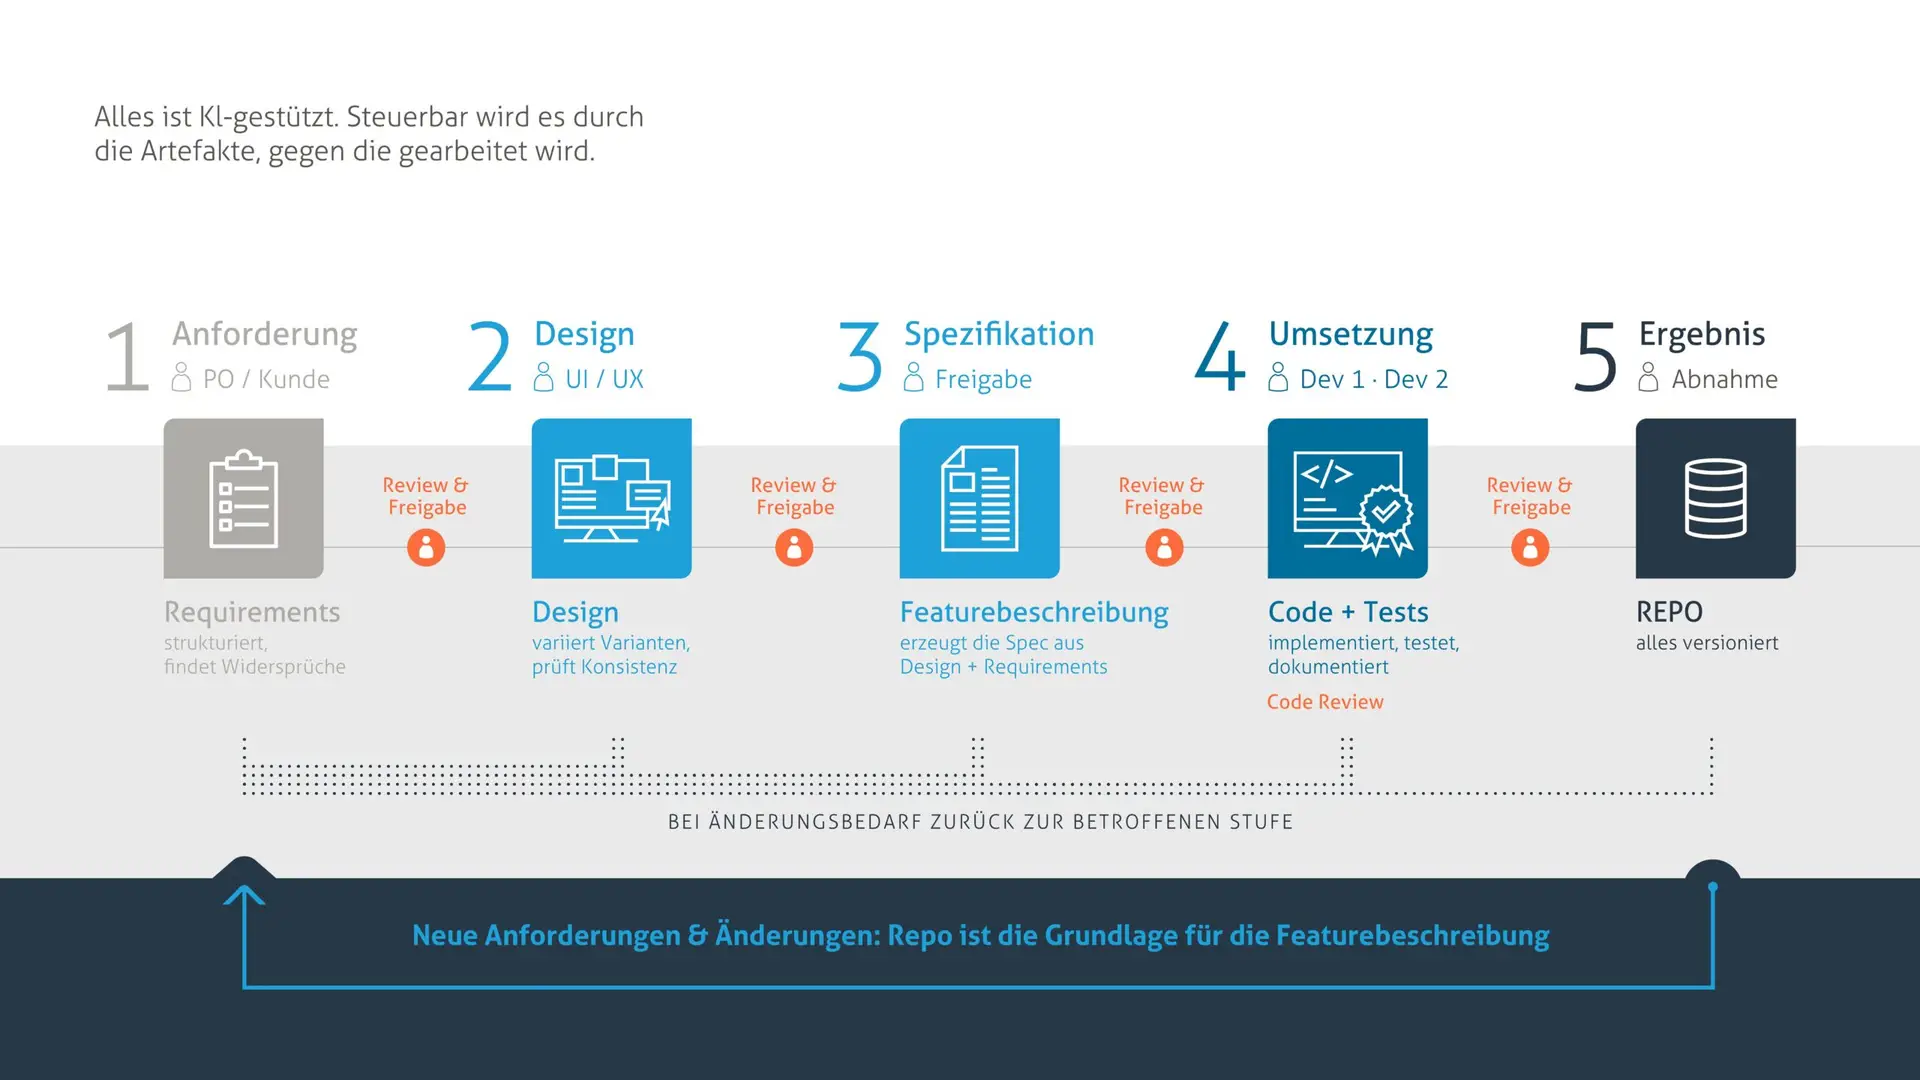
Anforderung und Domänenkontext klären: Fachseite und Entwicklung beschreiben gemeinsam die gewünschte Änderung. Bei der Prüffunktion legen sie fest, welche Produktvariante hinzukommt, welche Merkmale geprüft werden und woran ein korrektes Ergebnis erkennbar ist.
Architekturbezug herstellen: Das Team ordnet die Änderung den betroffenen Modulen zu und prüft Schnittstellen, Abhängigkeiten und Laufzeitanforderungen. Dabei berücksichtigt es auch die gemeinsam genutzte Bibliothek für die Bildvorverarbeitung. Es klärt, ob die Erweiterung ohne Änderungen an dieser Bibliothek auskommt oder ob deren Anpassung zusätzliche Regressionstests für die betroffenen Varianten erfordert.
Featurebeschreibung prüfen und versionieren: Zuständigkeiten, stets einzuhaltende Bedingungen (Invarianten), Akzeptanzkriterien und Fehlerfälle werden abgestimmt. Für die neue Prüfvariante gehören dazu auch Grenzwerte, zulässige Eingaben und das Verhalten bei fehlenden Daten. Die geprüfte und freigegebene Beschreibung wird versioniert und bildet die verbindliche Grundlage für Umsetzung und Prüfung.
Code und Tests KI-gestützt erzeugen: Die KI erhält neben der Aufgabe die freigegebene Featurebeschreibung sowie den relevanten Domänen- und Architekturkontext. Sie kann Änderungen am Prüfmodul vorschlagen und Tests aus den Akzeptanzkriterien ableiten. Die Anforderungen der Aufgabe bestimmen auch die Modellwahl. Für eine klar abgegrenzte Anpassung kann ein kleineres Modell genügen. Die Analyse einer gewachsenen Codebasis kann ein leistungsfähigeres Modell erfordern. Ob ein Modell lokal oder als externer Dienst betrieben wird, hängt unter anderem von Datenschutz, verfügbarer Infrastruktur, Kosten und Verfügbarkeit ab.
Ergebnisse prüfen und freigeben: Das Team prüft im Review, ob Code und Tests mit der Featurebeschreibung übereinstimmen. Automatisierte Tests mit vorab festgelegten Eingaben und erwarteten Ergebnissen überprüfen das Verhalten der neuen Prüfvariante. Regressionstests prüfen, ob bestehende Varianten weiterhin korrekt bewertet werden. Das Team kontrolliert außerdem, ob die Änderung auf die vorgesehenen Module begrenzt geblieben ist. Die Freigabe erfolgt durch die dafür verantwortlichen Personen anhand der vereinbarten Prüfergebnisse.
Code und Tests dürfen dabei nicht ausschließlich voneinander abgeleitet werden, da beide sonst dieselbe falsche Annahme enthalten können. Die unabhängig geprüfte Featurebeschreibung bleibt ihre gemeinsame Referenz. Die Verantwortung für fachliche Entscheidungen, die Einhaltung der Architekturgrenzen und die Freigabe kritischer Funktionen bleibt beim Team. Entscheidungen und Freigaben werden nachvollziehbar dokumentiert. Der Prozess ist nicht an einen bestimmten KI-Anbieter gebunden.
Was Maschinenhersteller daraus gewinnen
Ein solcher Entwicklungsprozess liefert mehr als schneller erzeugten Code. Klar zugeordnete Module begrenzen den Änderungsradius. Versionierte Beschreibungen halten fachliches Wissen im System. Automatisierte Tests zeigen, ob neue und bestehende Anforderungen nach einer Erweiterung weiterhin erfüllt sind.
Damit wird der eigentliche Mehrwert von Software Defined Manufacturing nutzbar: Maschinenfunktionen lassen sich über den Produktlebenszyklus weiterentwickeln und in weiteren Varianten einsetzen. Softwarebasierte Services können auf einer Architektur aufbauen, deren Fähigkeiten und Schnittstellen bekannt sind. Auch regulatorische Anforderungen werden handhabbarer, weil Änderungen, Abhängigkeiten und Prüfergebnisse nachvollziehbar bleiben. Hier schließt SDM an Themen wie den Cyber Resilience Act, den EU Data Act und den kontrollierten Datenaustausch in Datenräumen an.
Für technische Entscheider beginnt der KI-Einsatz deshalb bei der vorhandenen Maschinensoftware und ihrem Entwicklungsprozess. Sind Verantwortlichkeiten, Schnittstellen und Testbasis geklärt, kann KI die Umsetzung beschleunigen, ohne dass Architekturwissen und fachliche Kontrolle verloren gehen.
iT Engineering Software Innovations unterstützt Maschinenhersteller dabei, diese Grundlagen zu schaffen und KI kontrolliert in die Softwareentwicklung einzubinden.
Ihr nächster Schritt:
Gemeinsam in die Zukunft starten
Sie möchten klären, wo Änderungen heute besonders viel Aufwand verursachen und wie ein prüfbarer Entwicklungsprozess für Ihre Maschinensoftware aussehen kann?
Kontaktieren Sie uns für ein unverbindliches Erstgespräch.
Wolfram Schäfer
Geschäftsführer iT Engineering Software Innovations


